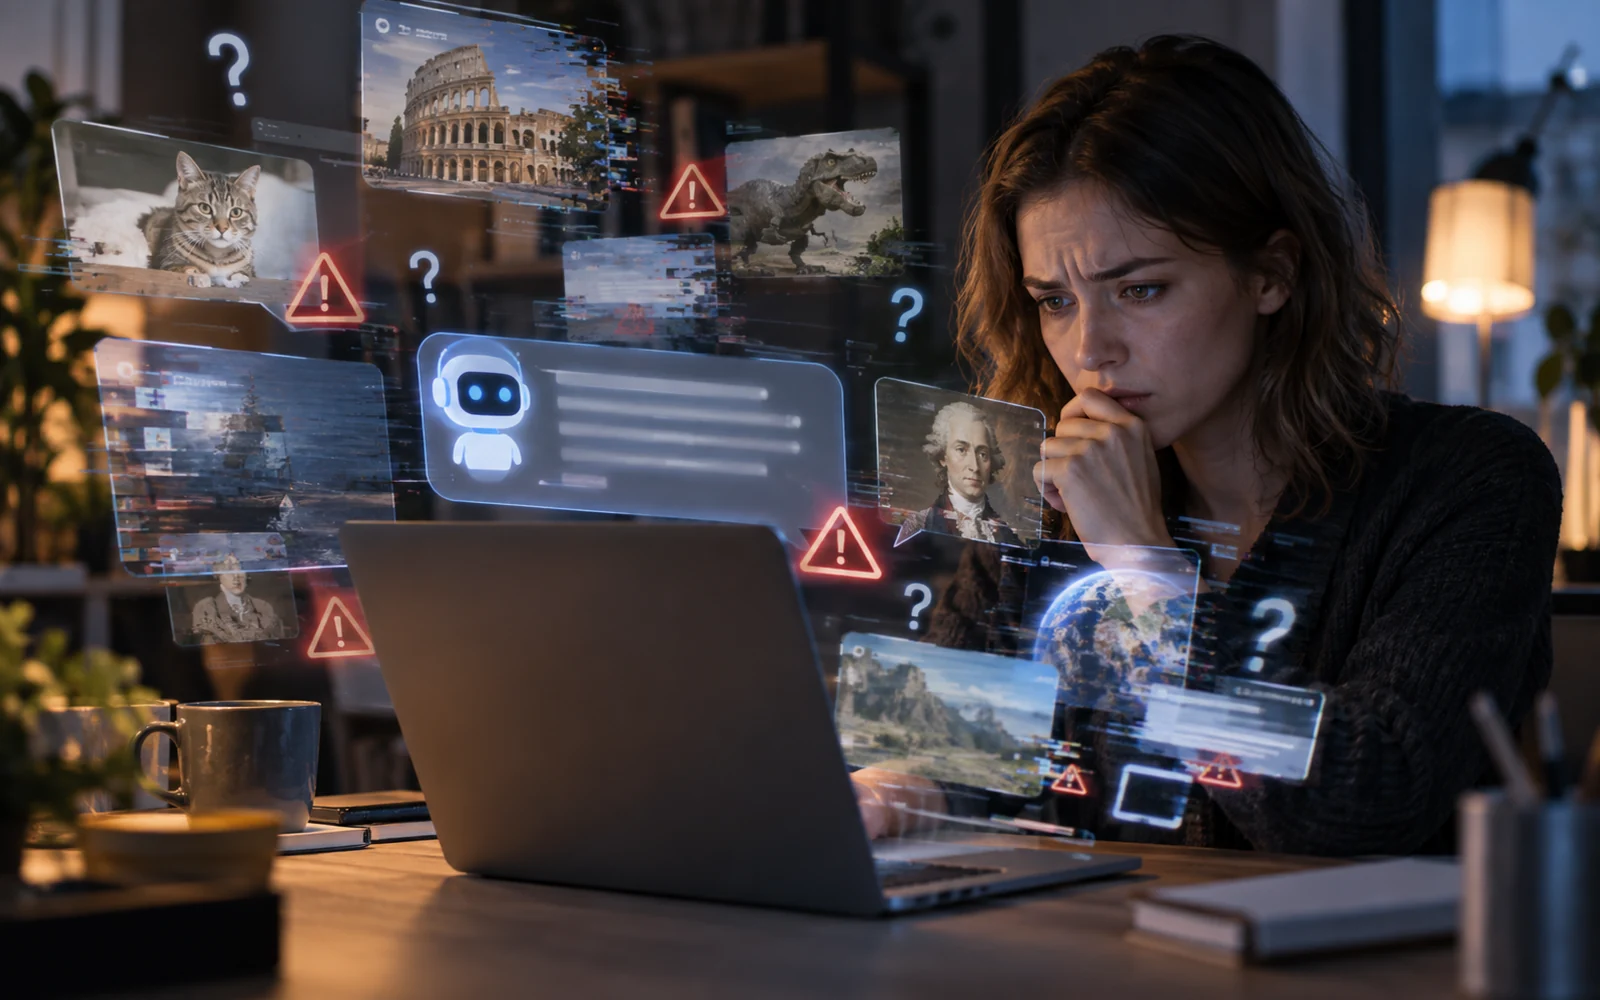
Požádáte chatbota o název vědecké studie a on bez zaváhání uvede autory, rok i odkaz. Po kliknutí zjistíte, že článek neexistuje. Jindy vytvoří přesvědčivý životopis, splete si zákony nebo připíše známé osobě výrok, který nikdy neřekla. Hladká formulace odpovědi je proto slabým důkazem její pravdivosti.
AI si dokáže vymýšlet fakta, protože jazykový model vytváří pravděpodobný text, nikoli automaticky ověřený popis reality. Takové chyby se nazývají halucinace a mohou zahrnovat neexistující zdroje, nesprávná data i přesvědčivá, ale nepravdivá vysvětlení. Riziko snížíte konkrétním zadáním, prací se skutečnými podklady a kontrolou důležitých tvrzení v nezávislých zdrojích. Ani vyhledávání nebo citace nejsou neomylnou zárukou.
Znamená to, že AI úmyslně lže?
Běžný jazykový model nemá důvod chápat jako člověk s vědomým úmyslem někoho oklamat. Když vygeneruje nesprávný údaj, přesnější je říci, že vytvořil nepravdivou odpověď nebo halucinaci. V běžné řeči se říká, že „lže“, tento výraz však může mylně naznačovat úmysl. Při hodnocení výsledku je důležitější, že jej uživatel nemůže bez ověření považovat za fakt.
Chybná odpověď navíc nemusí být zcela smyšlená. Model může spojit údaje o dvou podobných osobách, zaměnit rok přijetí zákona s datem účinnosti nebo uvést skutečnou studii jako podporu tvrzení, které se v ní nenachází. Takové kombinované chyby se odhalují hůře než očividný nesmysl.
Jak halucinace vznikají
Jazykové modely se během tréninku učí vzorce v rozsáhlých textových datech. Zjednodušeně řečeno odhadují další části textu na základě kontextu. Tento proces jim umožňuje vytvářet výborná vysvětlení, překlady i pracovní návrhy, sám o sobě ale nevytvoří spolehlivý rejstřík ověřených faktů. Predikce jazykově přesvědčivé odpovědi se liší od důkazu, že odpověď odpovídá skutečnosti.
Výzkumná práce OpenAI o halucinacích upozorňuje také na problém hodnocení modelů: systémy mohou získávat lepší skóre, když hádají, než když přiznají nejistotu. U složité otázky tak model vyplní mezeru odpovědí, která zní správně. Pokud se nenaučí přiměřeně říct „nevím“, uživatel získá falešný pocit jistoty.
Smyšlená tvrzení mohou pocházet také z nedostatečného kontextu, nejednoznačného zadání nebo zastaralých informací. Pokud se zeptáte na čerstvé rozhodnutí úřadu bez dostupného aktuálního podkladu, samotná plynulost odpovědi nenahradí přístup k přesnému znění. A ani dostupný dokument nezaručí, že model správně vyloží jeho výjimky či přechodná ustanovení.
Nejtypičtější chyby, které vypadají důvěryhodně
Fiktivní bibliografie je častým příkladem. Model vytvoří realistický název studie, přiřadí skutečně existujícího vědce a doplní nepravdivý identifikátor. Výsledek může na první pohled vypadat lépe než článek bez zdrojů. Kontrola však znamená citovanou publikaci skutečně otevřít a ověřit, zda vůbec existuje a podporuje konkrétní tvrzení.
Další chybou jsou čísla bez kontextu. Model může tvrdit, že výrobek má určitý výkon, země přijala pravidlo v přesném roce nebo služba stojí konkrétní částku. Pokud údaje nemá z ověřeného aktuálního ceníku či dokumentace, přesnost na dvě desetinná místa není důvodem výsledku věřit. Pozornost si zaslouží i generované citace zákonů s nesprávným paragrafem.
Zavádějící mohou být dokonce i odpovědi, v nichž jsou jednotlivá fakta správná. Model je může spojit do nesprávného závěru, vynechat podstatnou výjimku nebo smíchat pravidla dvou zemí. U zdravotních, právních či finančních témat proto nestačí kontrolovat jedno číslo: je třeba prověřit logiku a platnost doporučení pro konkrétní případ.
Pomůže, když požádáte o zdroje?
Ano, zdroje jsou užitečné, ale jen pokud je skutečně otevřete. Požadavek „přidej odkazy“ může zvýšit transparentnost, model ale může vygenerovat i neexistující URL nebo použít skutečný odkaz k nesprávnému tvrzení. Lepší je pracovat s konkrétními dokumenty, přesnými názvy a daty, které lze nezávisle ověřit.
IBM popisuje metodu RAG, při níž systém nejprve vyhledá informace ve zvoleném zdroji a poté na jejich základě odpovídá. Takové ukotvení může halucinace omezit, ale nevyloučí je: vyhledávání může přinést nesprávný dokument, stránka může být zastaralá a model může text špatně pochopit. „Má přístup k internetu“ proto neznamená „všechno ověřil“.
U pracovního úkolu se vyplatí výslovně určit, co je povoleným zdrojem a co se má stát, když informace chybí. Například požadavek „odpovídej jen z přiloženého ceníku, při nejasnosti napiš, že údaj není uveden“ je lepší než obecné „napiš mi správnou cenu“. I tak zůstává kontrola na člověku, který výsledek publikuje nebo používá při rozhodování.
Jak si odpověď prakticky ověřit
Nejprve rozdělte odpověď na konkrétní tvrzení. Jména, data, ceny, zákonné povinnosti a statistiky se ověřují snáze než obecné formulace. U každého důležitého bodu hledejte původní dokument: rozhodnutí úřadu, technickou dokumentaci výrobce, vědeckou studii či aktuální obchodní podmínky. Sekundární článek může pomoci s orientací, ale při sporném detailu dejte přednost primárnímu zdroji.
Zkontrolujte také časový údaj. Správná informace z minulého roku nemusí platit pro dnešní produkt nebo novelizovaný zákon. U údajů z jiných zemí se ptejte na jurisdikci a u vědeckých závěrů na to, zda jde o jednu studii, nebo o potvrzený širší soubor důkazů. Nesnažte se model přesvědčit, že vámi požadovaný závěr je pravdivý: může se vám přizpůsobit a vytvořit falešné potvrzení.
Pokud se odpověď opakovaně mění při mírné úpravě otázky, je to důvod k větší opatrnosti. Naopak opakovaně stejná odpověď není důkazem – model může konzistentně opakovat tutéž chybu. Rozhodují nezávislé důkazy, nikoli sebevědomý styl ani počet pokusů.
Kdy lze AI používat i bez rozsáhlého ověřování
Při návrhu struktury textu, generování nápadů nebo jazykové úpravě vlastního odstavce bývá riziko menší, pokud model nepřidává nová fakta. Jiná situace nastává při zveřejňování zdravotního doporučení, účetního postupu nebo konkrétní právní rady. V takovém případě by měl výsledek projít kontrolou člověka s příslušnou odborností a ověřením zdrojů.
Zdravým návykem není AI se zcela vyhýbat, ale rozlišovat mezi kreativní pomůckou a autoritativním zdrojem. Model může urychlit přípravu a upozornit na otázky, které by vás nenapadly. Za pravdivost a důsledky veřejně zveřejněného tvrzení však neodpovídá hezky formulovaná věta, ale ten, kdo ji použije.
Zdroje
- OpenAI – Proč jazykové modely halucinují (výzkumné vysvětlení a problém odměňování hádání) – https://openai.com/sk-SK/index/why-language-models-hallucinate/
- IBM – What Are AI Hallucinations? (typy chyb a možnosti omezení) – https://www.ibm.com/think/topics/ai-hallucinations
- IBM – What is RAG (Retrieval Augmented Generation)? (práce s podklady a její limity) – https://www.ibm.com/think/topics/retrieval-augmented-generation
Gabriel Čatár
Zajímají mě věci, se kterými se setkáváme každý den, ale často nevíme, jak vlastně fungují. Od technologií a financí přes praktické návody až po zajímavosti ze světa. Na Offpitchi se věnuji tématům, u kterých stojí za to jít trochu více do hloubky, ověřit si fakta a vysvětlit je jednoduchým způsobem. Mým cílem je, aby si čtenář z každého článku odnesl něco užitečného.

